万维网WWW
本节课我们介绍万维网并非某种特殊的计算机网络,它是一个大规模的联机式的信息储藏所,是运行在因特网上的一个分布式应用。
它利用网页之间的超链接,将不同网站的网页链接成一张逻辑上的信息网。
万维网是欧洲粒子物理实验室的Tim berners-Lee最初于 1989 年3月提出的。
1993 年2月诞生了世界上第一个图形界面的浏览器Mosaic。
1995 年,著名的Netscape Navigator浏览器(网景)上市。
目前比较流行的浏览器有 Chrome 浏览器、火狐浏览器、 Safari 浏览器、欧鹏浏览器、 IE 浏览器。
浏览器最重要的部分是渲染引擎,也就是浏览器内核,负责对网页内容进行解析和显示,这是上述各浏览器使用的内核。
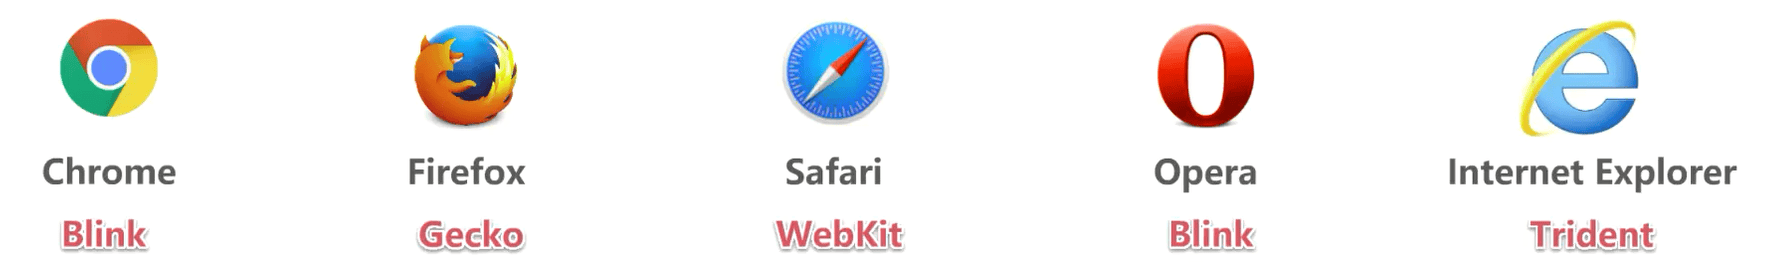
不同的浏览器内核对网页内容的解析也有所不同,因此同一网页在不同内核的浏览器里的显示效果可能不同,
网页编写者需要在不同内核的浏览器中测试网页显示效果。
举例说明万维网应用
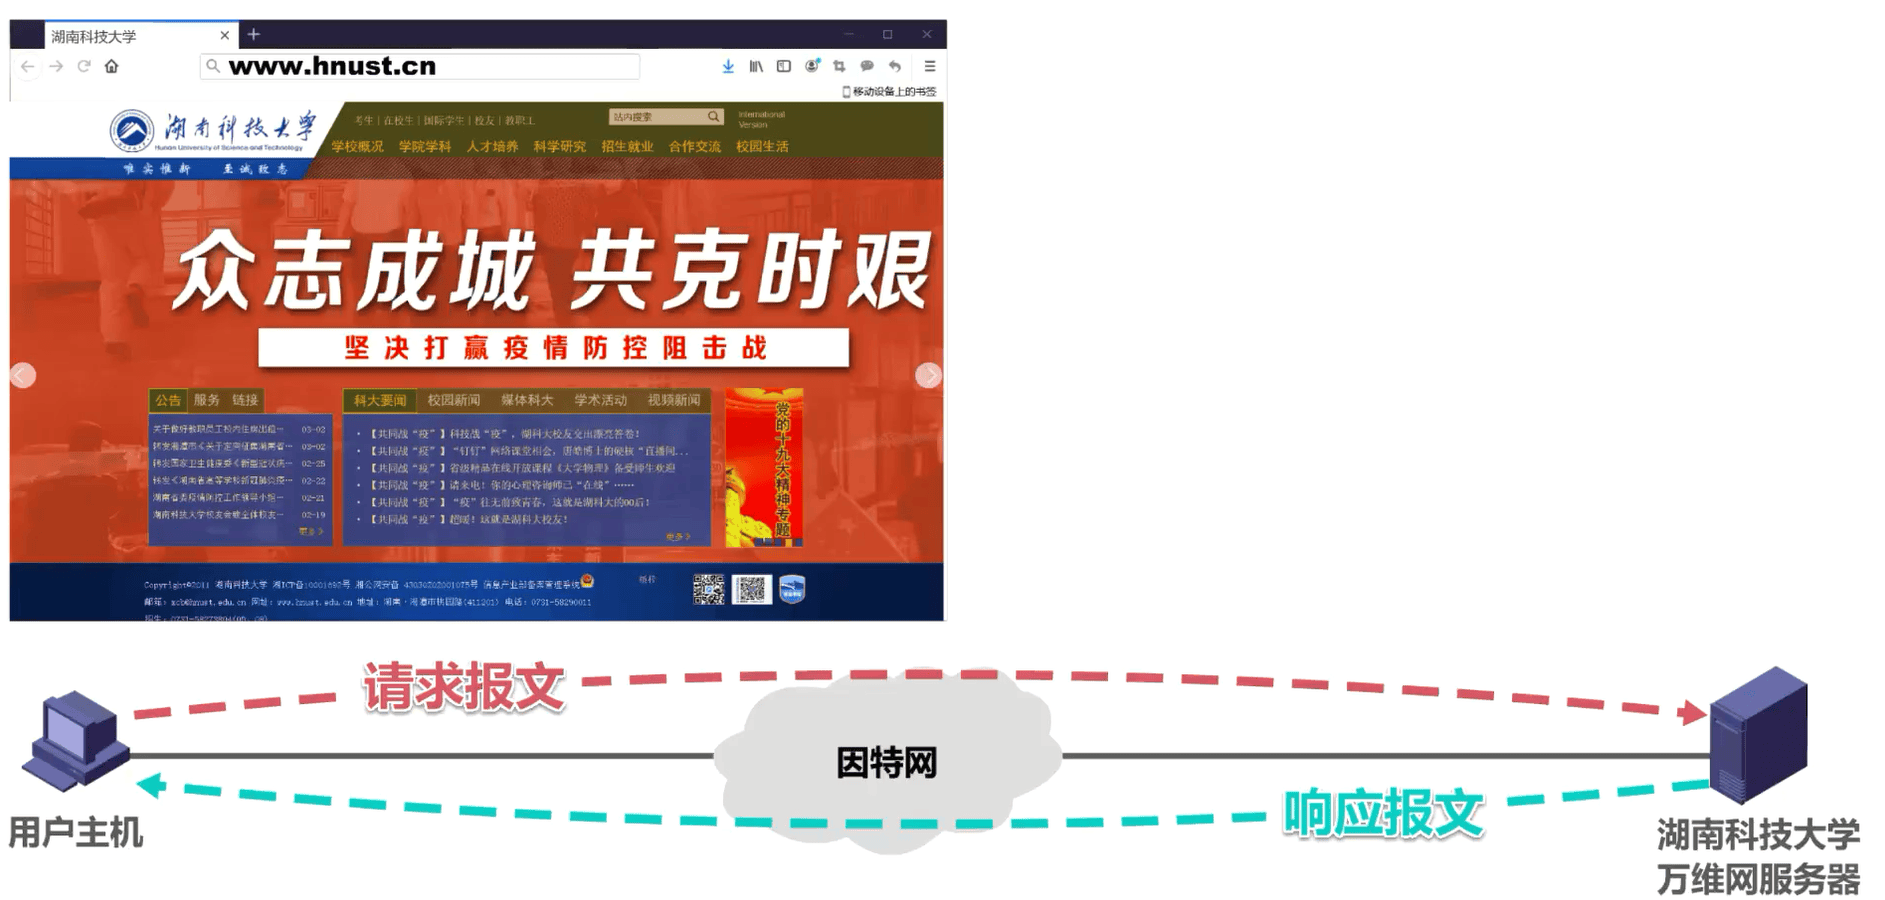
我们在用户主机中使用浏览器来访问湖南科技大学的万维网服务器,也就是访问湖南科技大学的官方网站。我们在浏览器的地址栏中输入湖南科技大学官方网站的域名,并按下回车键后,浏览器将发送请求报文给服务器,服务器收到请求报文后执行相应操作,然后给浏览器发回响应报文,浏览器解析并渲染响应报文中的内容,这样我们就可以看到网站首页了。
统一资源定位符
为了方便的访问在世界范围的文档,万维网使用统一资源定位符URL来指明因特网上任何种类资源的位置。
统一资源定位符的一般形式由以下四个部分组成,分别是协议主机、端口、路径。

我们之前在浏览器地址栏中输入的是湖南科技大学官方网站的域名,目的是获取网站首页的内容,其对应的统一资源定位符如图所示。

当我们点击网页中的某个超链接时,将跳转到另一个网页,可以看到这是该网页相应的统一资源定位符。其中协议主机和端口与网站首页相同,不同的是路径和网页文件。

万维网文档
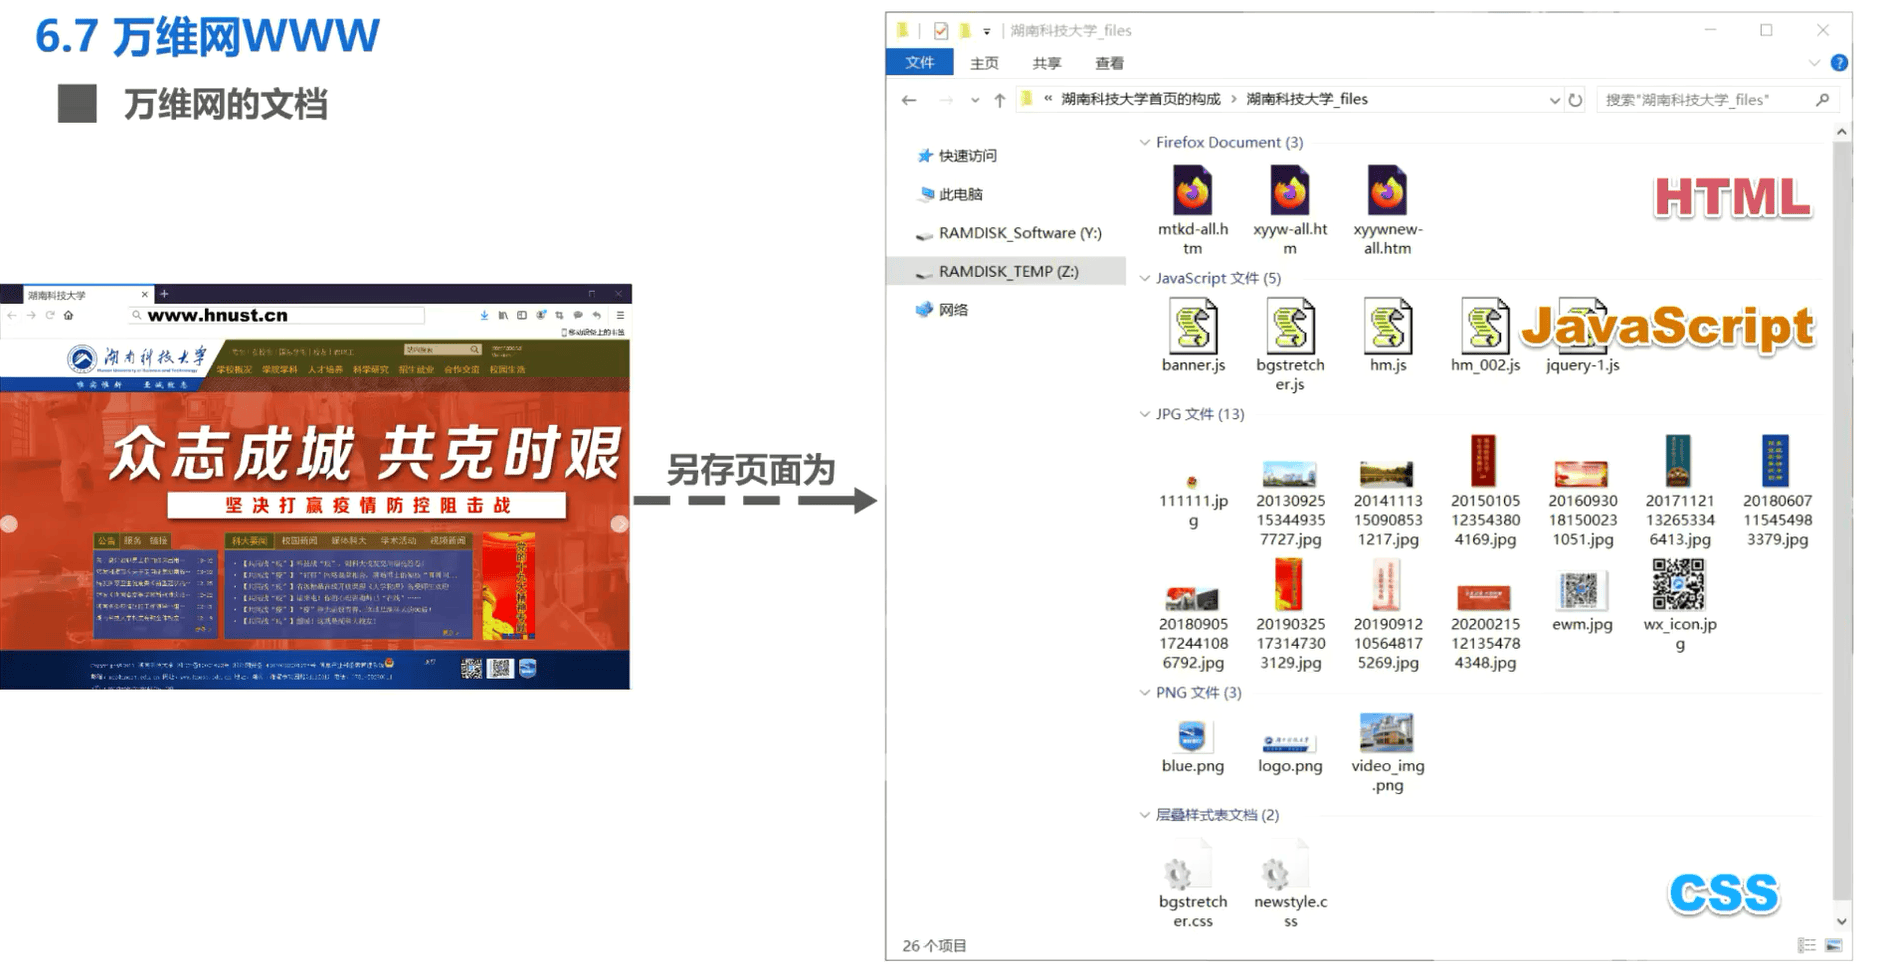
接下来我们介绍万维网文档,这是我们之前访问的湖南科技大学官方网站的首页,我们可以将其另存为文件。可以看到有一个扩展名为 HTML 的文件和一个文件夹,我们打开该文件夹看看其内容。这 3 个扩展名为htm 的文件是HTML 文档。这 5 个扩展名为 js 的文件是 Javascript 文档。这两个扩展名为css的文件是css文档。其他的JPG文件和PNG文件是图片文件。
HTML是超文本标记语言的英文缩写词,它使用多种标签来描述网页的结构和内容。
CSS 是层叠样式表的英文缩写词,它从审美的角度来描述网页的样式。
Javascript 是一种脚本语言,用来控制网页的行为。
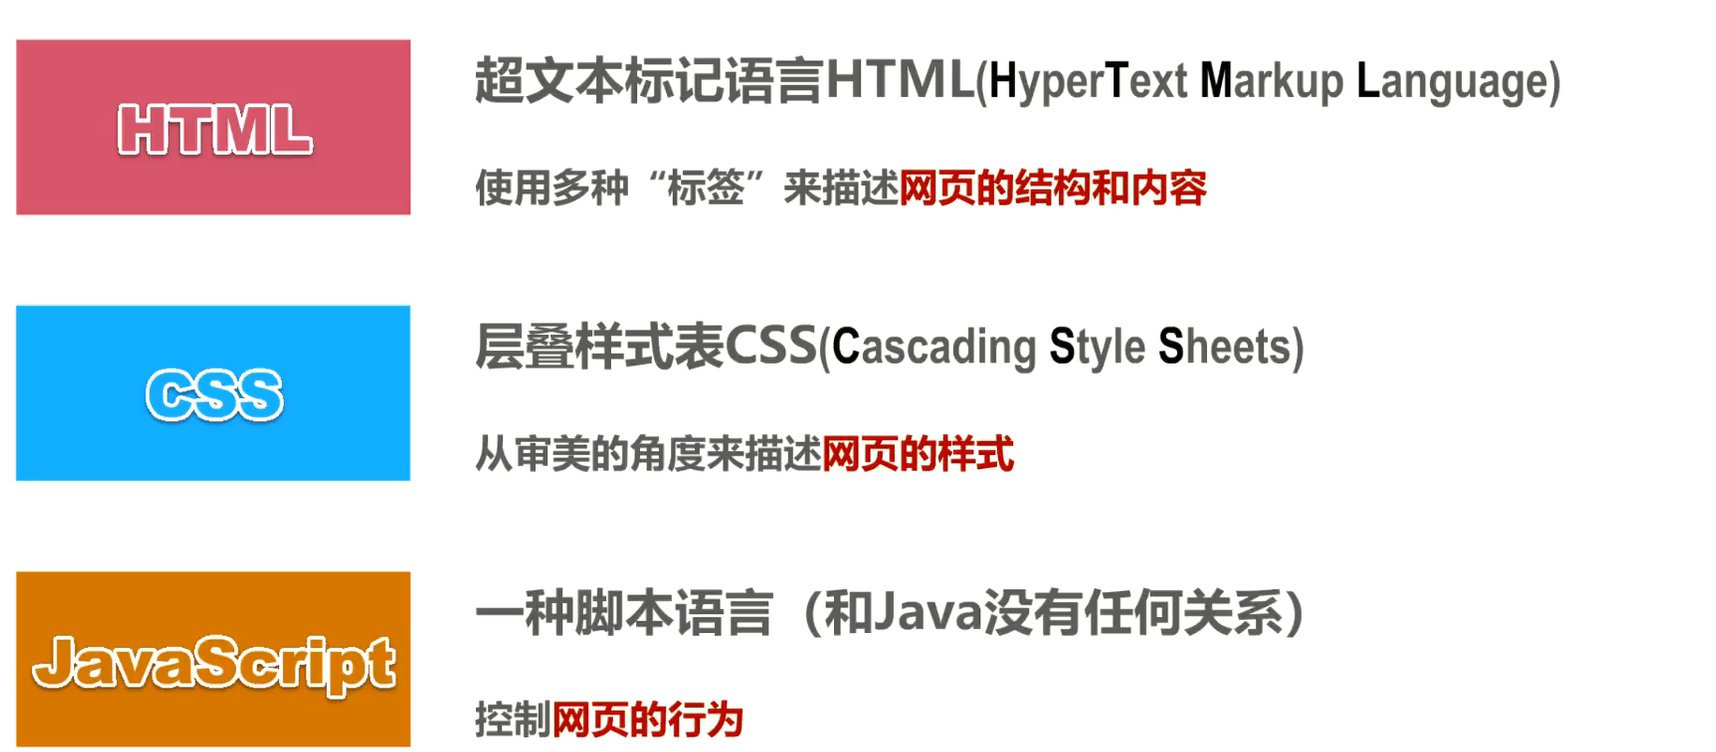
由 HTML 、CSS、Javascript 编写的万维网文档由浏览器内核负责解释和渲染。
举例说明浏览器内核的解释和渲染
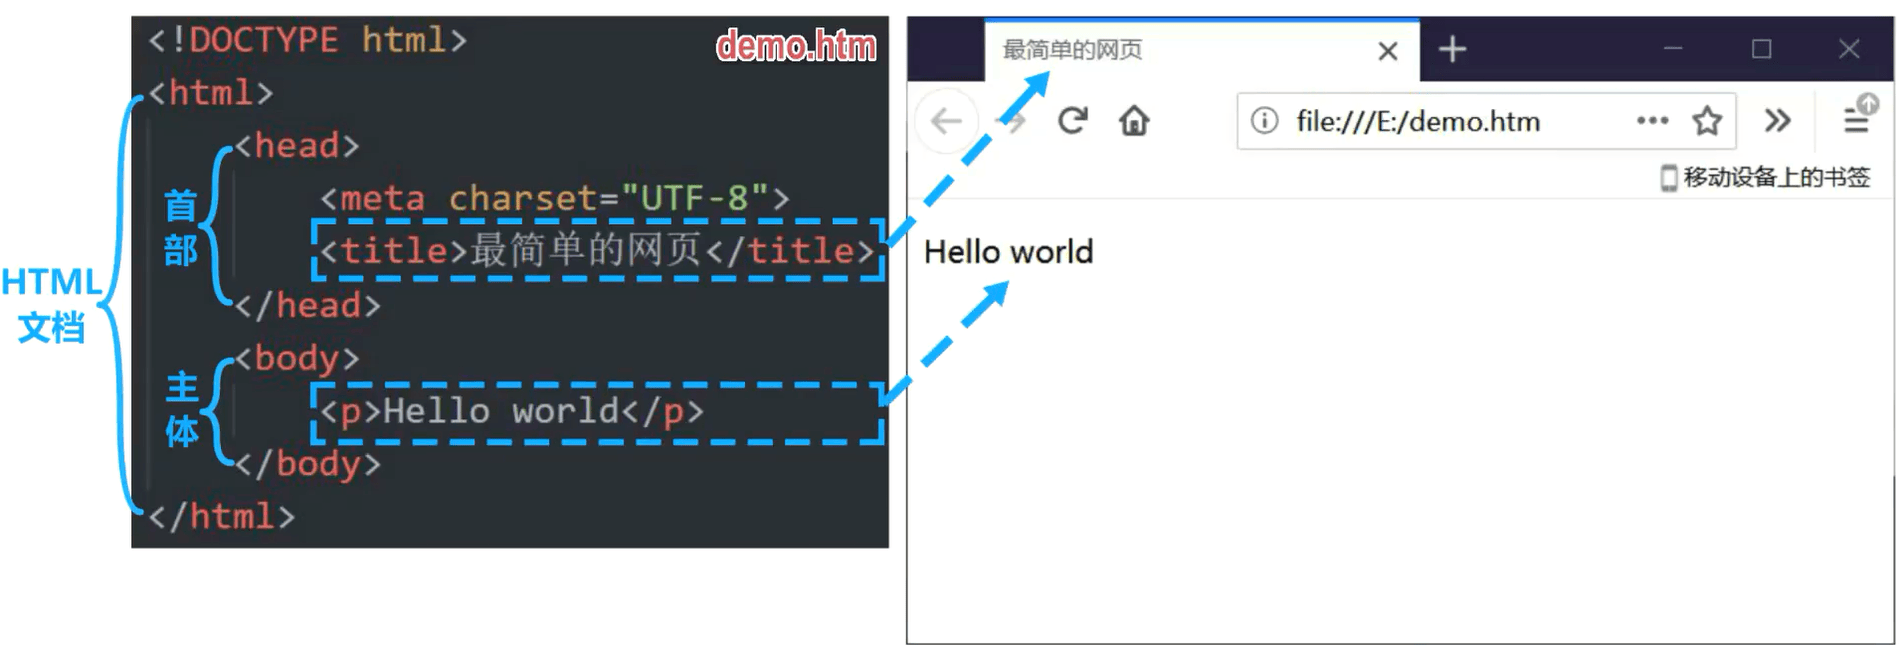
我们来举例说明。这是用HTML编写的最简单的HTML文档。用浏览器打开该HTML文档,可以看到浏览器渲染出了一个非常简单的网页。在HTML文档中,使用两个HTML标签来定义HTML文档的范围。在其内部使用两个 head 标签定义HTML文档的首部。使用两个 body 标签定义HTML文档的主体。首部中两个 title 标签之间的内容被渲染为网页的标题,两个 p 标签之间的内容被渲染为一个文本段落。
通过本例可以看出,HTML 是用多种标签来描述网页的结构和内容,但是所呈现出来的内容样式过于简单,或者说不够美观。我们可以在 CSS 文档中定义一些所需要的样式,对网页显示内容进行美化。
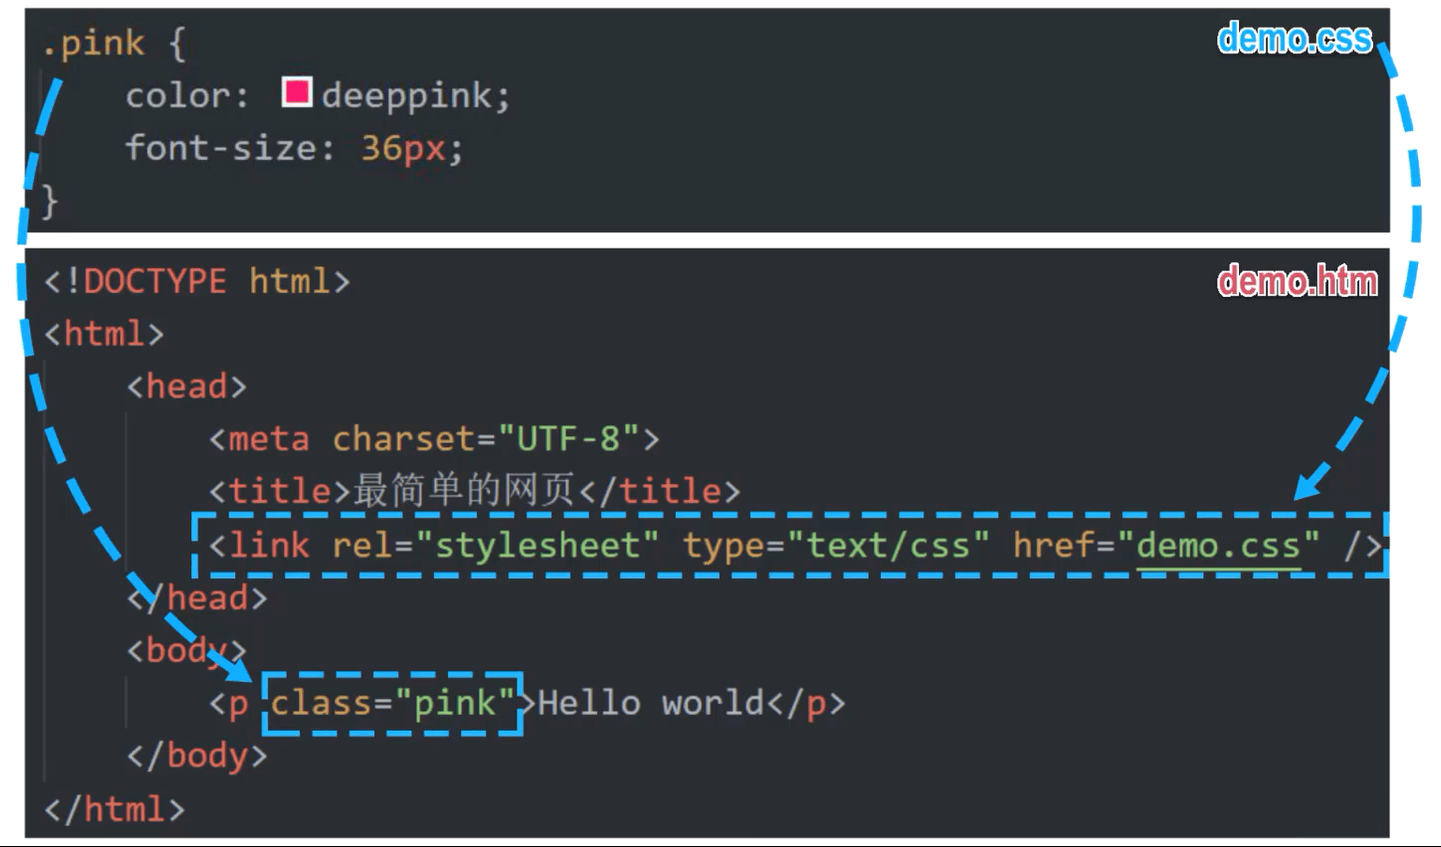
例如,我们编写了这样一个 CSS 文档,在其中定义了一种样式,借颜色为深粉色,字体大小为 36 个像素。然后,我们在之前编写好的HTML文档的首部使用 link 标签将该css文档引入,将样式名称指定给主体中需要更改样式的那个 p 标签
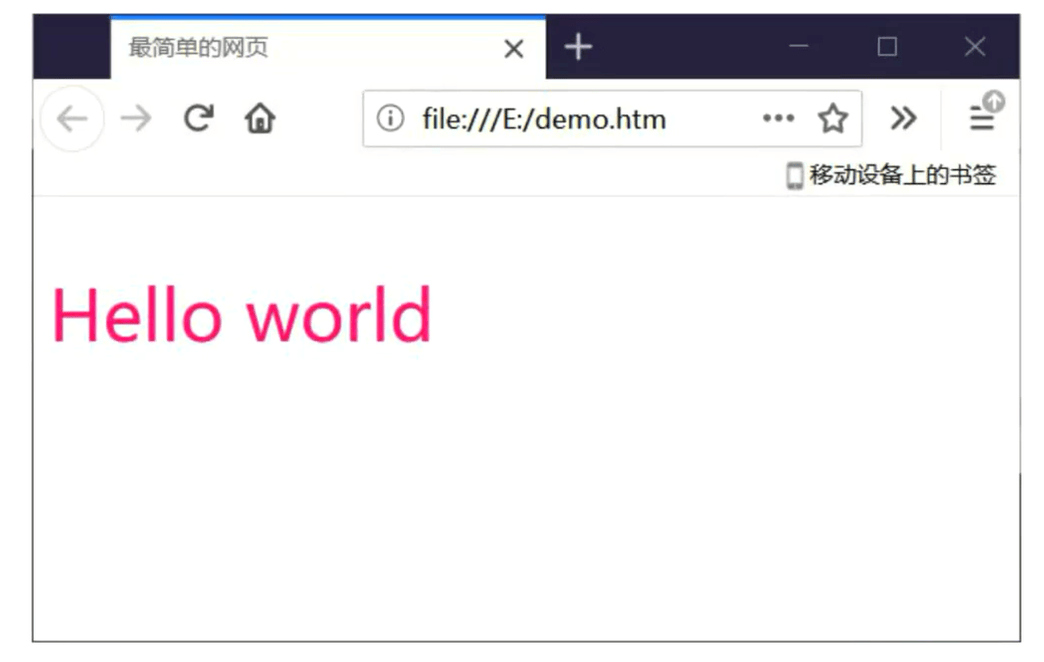
现在我们在浏览器中进行刷新,就可以看到浏览器重新渲染出了网页内容,可以看到 hello world 段落的颜色和字体大小都发生了相应的变化。
接下来我们再给该网页添加一个按钮,在之前的HTML 文档的主体中,使用 button 标签来添加一个按钮,我们为该按钮指定一个发生单机事件时应该调用的处理函数,然后用 Javascript 的脚本语言来编写一个 JS 文档,在该文档中编写单机事件处理函数的具体实现代码。
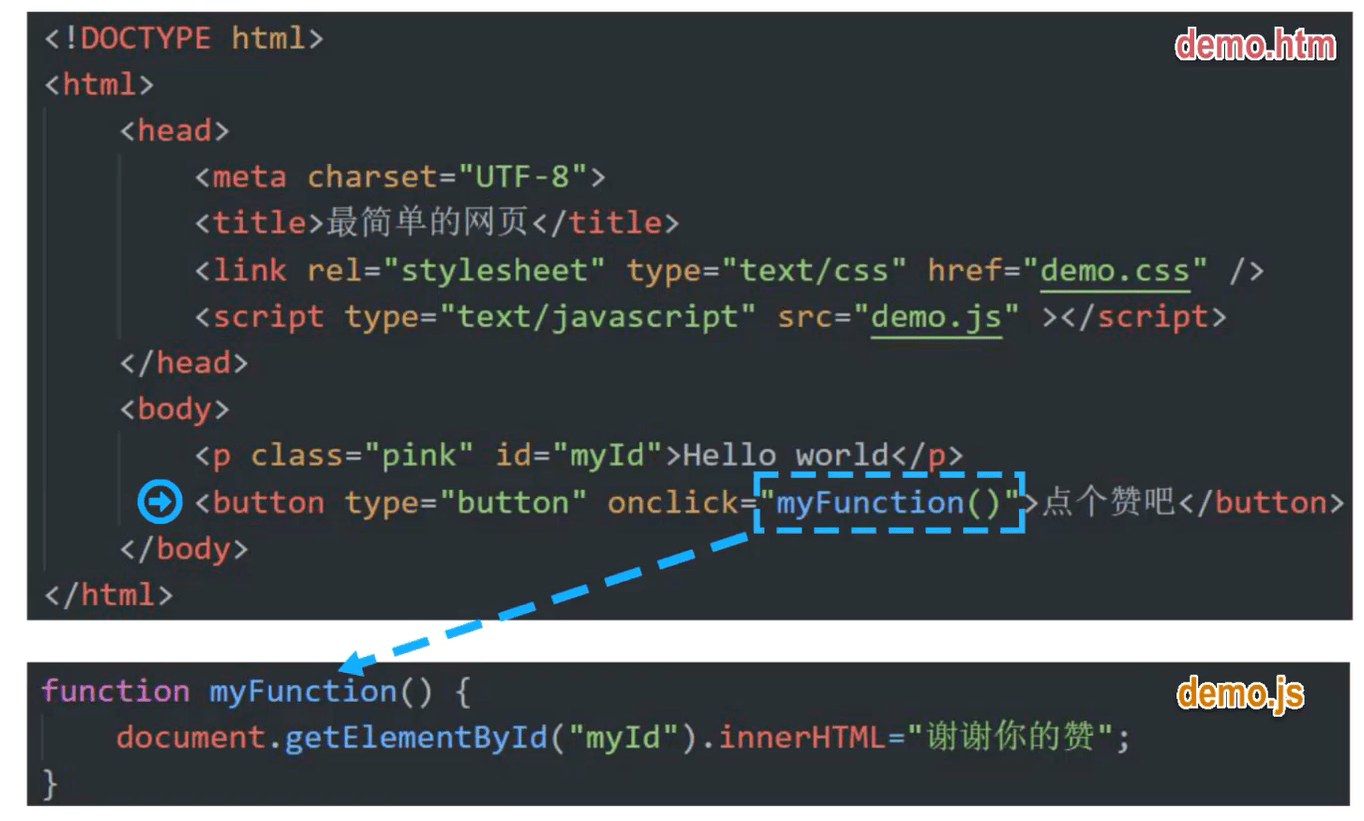
在 HTML 文档的首部,使用 script 标签将该 JS 文档引入。在事件处理函数中,通过元素的 ID 来找到相应的元素,也就是显示 hello world 的 p 标签,然后更改其显示内容。现在我们在浏览器中进行刷新,就可以看到我们所添加的按钮。当我们用鼠标点击该按钮时,hello world 变成了谢谢你的赞。
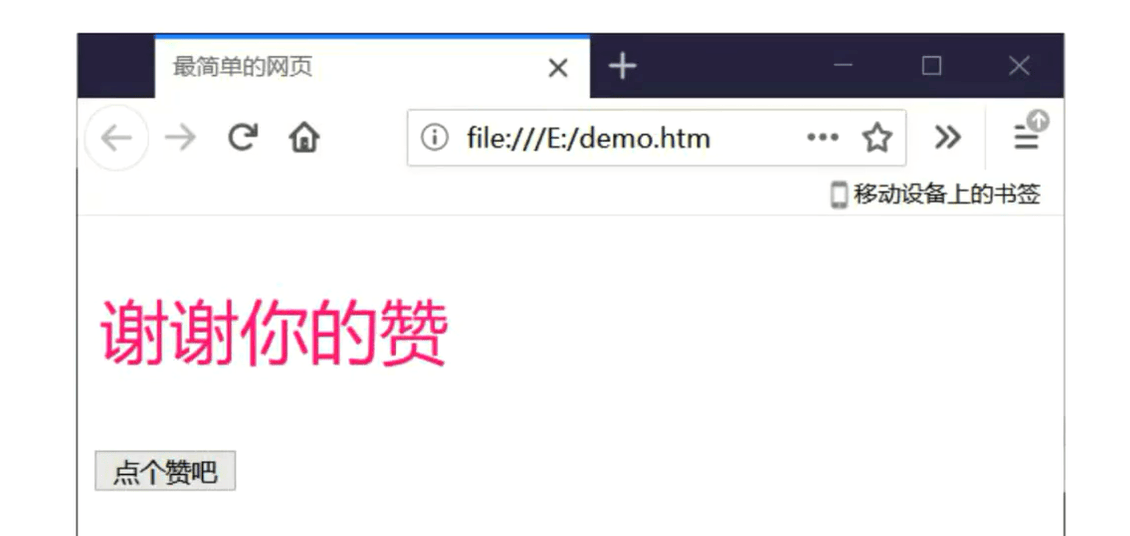
通过上述举例,相信同学们对HTML 文档、 css 文档、 Javascript 文档已经有了初步的认识。需要大家注意的是,这些文档都部署在服务器端,有一些是外部前端人员开发设计好的静态页面,有一些是服务器后端程序根据用户需求自动生成的动态页面,他们都需要从服务器传送给用户的浏览器进行解析和渲染,这就不得不提到 TCP/IP 体系应用层中的一个非常重要的协议。
超文本传输协议HTTP
HTTP 定义了浏览器解万维网客户进程怎样向万维网服务器请求万维网文档,以及万维网服务器怎样把万维网文档传送给浏览器。
举例说明HTTP协议
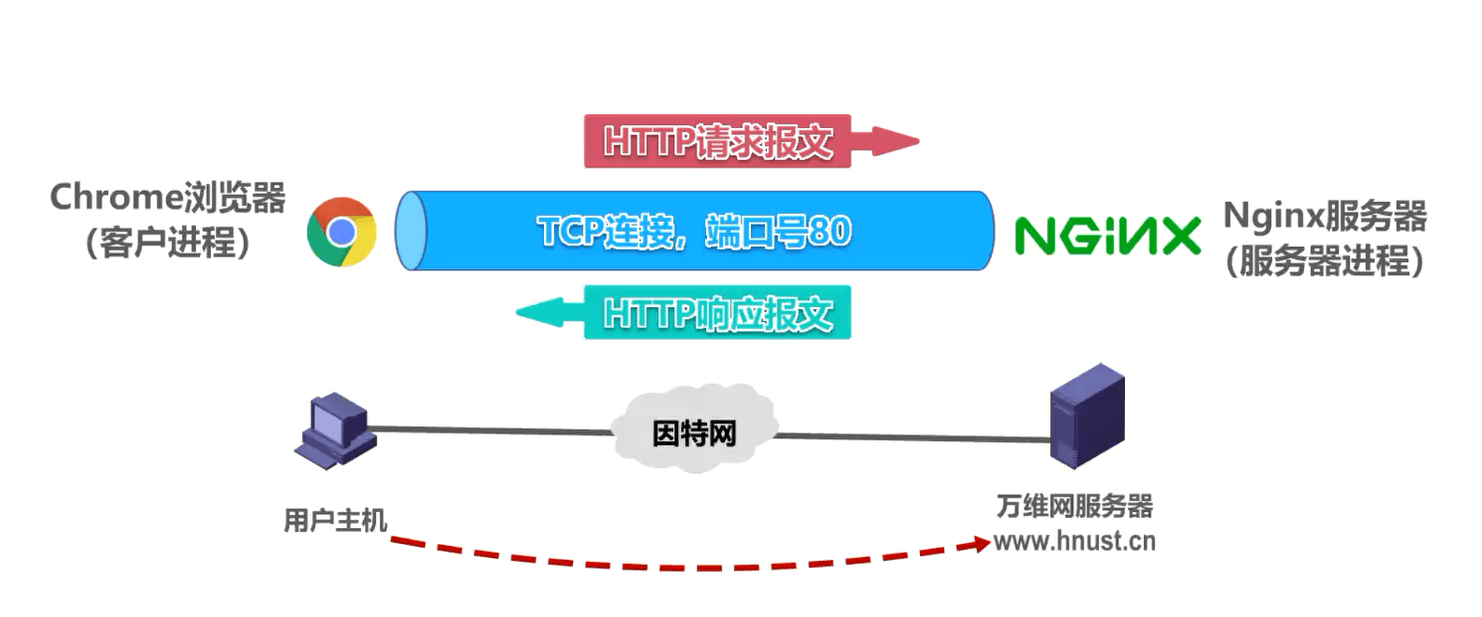
我们使用用户主机来访问湖南科技大学的万维网服器,可以看成是用户主机中的浏览器进程即客户进程与服务器中的服务器进程基于因特网的通信,浏览器进程首先发起与服务器进程的 TCP 连接,使用熟知端口号80。基于这条已建立好的 TCP 连接,浏览器进程向服务器进程发送 HTTP 请求报文,服务器进程收到后执行相应操作,然后给浏览器进程发回 HTTP 响应报文。
HTTP 1.0
HTTP 1. 0 采用非持续连接方式,在该方式下,每次浏览器要请求一个文件,都要与服务器建立 TCP 连接,当收到响应后就立即关闭连接。
我们来举例说明
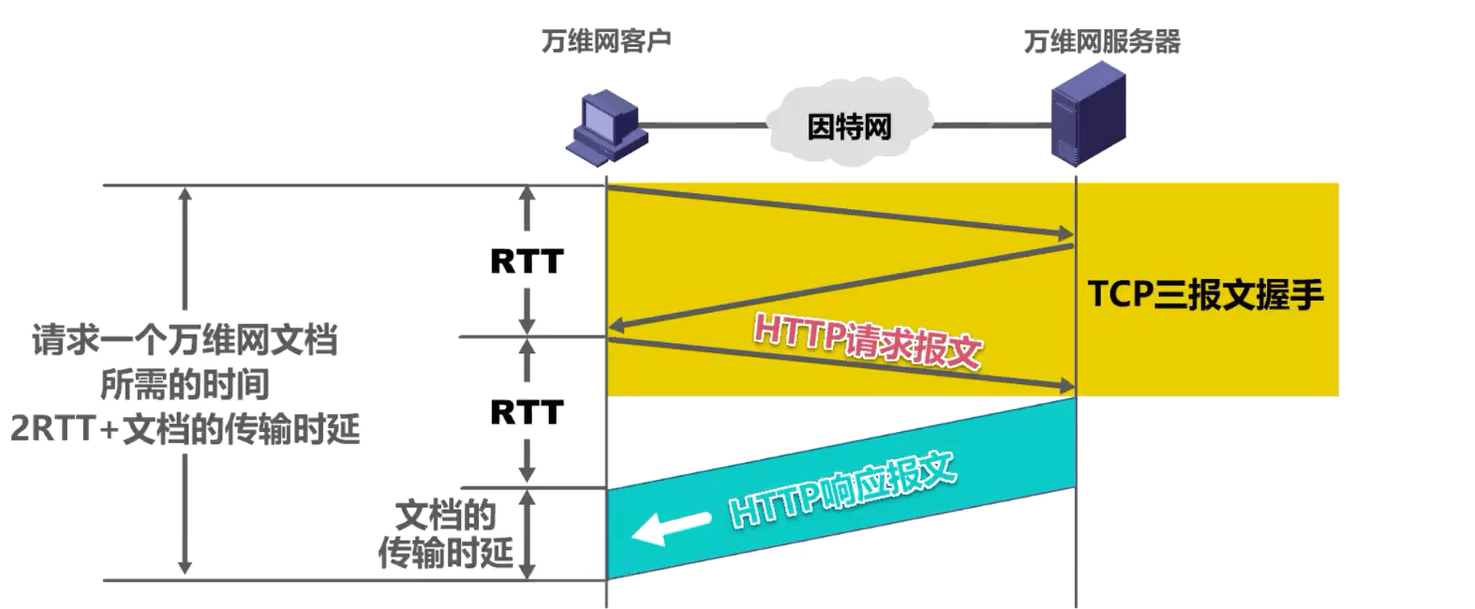
这是客户与服务器之间通过三报文握手进行 TCP 连接。在这 3 个报文中的最后一个报文的数据载和部分携带有 HTTP 请求报文,服务器收到后给客户发回 HTTP 响应报文,这是一次请求和响应所耗费的时间。
记为往返时间RTT,这又是一次请求和响应所耗费的时间RTT。这是文档的传输时延,可以看到请求一个万维网文档所吸的时间为 2 倍的 RTT 加文档的传输时延。每请求一个文档就要有 2 倍 RTT 的开销。若一个网页上有很多引用对象,例如图片等,那么请求每一个对象都需要额外花费 2 倍的 RTT 的时间。
为了减少时延,浏览器通常会建立多个并行的 TCP 连接,同时请求多个对象,但是这会大量占用万维网服器的资源,特别是万维网服务器往往同时服务于大量客户的请求,这会使其负担很重。
HTTP 1.1
HTTP 1. 1 采用持续连接方式,在该方式下,万维网服务器在发送响应后仍然保持这条连接,使同一个客户和该服务器可以继续在这条连接上传送后续的 HTTP 请求报文和响应报文,这并不局限于传送同一个页面上引用的对象,而是只要这些文档都在同一个服务器上就行。
为了进一步提高效率, HTTP 1. 1 的持续连接还可以使用流水线方式工作,借浏览器在收到 HTTP 的响应报文之前,就能够连续发送多个请求报文,这样的一个接一个的请求报文到达服务器后,服务器就发回一个接一个的响应报文,这样就节省了很多个 RTT 时间,使 TCP 连接中的空闲时间减少,提高了下载文档的效率。
接下来我们介绍 HTTP 的报文格式。 HTTP 是面向文本的,其报文中的每一个字段都是一些阿斯克马串,并且每个字段的长度都是不确定的。首先来看 HTTP 请求报文的格式,我们用很窄的小格子表示空格,用标有c、r、l、 f 的格子表示回车换行 h TTP。请求报文的第一行是请求行,由方法字段开始,其后跟一个空格,后跟统一资源定位符字段,其后跟一个空格,后跟版本字段,最后是回车换行。从第二行开始就是首部行,每一个首部行由首部字段名开始,其后跟一个冒号,再跟一个空格,然后是该字段的取值,最后是回车换行。可以有多个首部行,如图所示。
在最后的首部行下面是一个空行,在空行下面是实体主体,通常不使用。我们来举例说明 HTTP 请求报文的格式,这是浏览器发送的 HTTP 请求报文的具体内容?第一行为请求行指明了方法, get 统一资源定位符以及 HTTP 的版本。这是第一个首部行,首部字段名为host,其职为湖南科技大学官方网站的域名。这是第二个首部行,首部字段名为connection,其值为close,这是告诉服务器发送完请求的文档后就可以释放连接。这是第三个首部行,首度自办,名为 user agent,其值是浏览器的类型及版本。这是第四个首部行,首部字段名为 accept language,其值为CN,这是告诉服务器用户希望优先得到中文版本的文档。在最后一个首部行的下面是一个空行,该 HTTP 请求报文没有实体主体, HTTP 请求报文支持以下方法我们就不再逐一介绍了。再来看 HTTP 响应报文的格式。 HTTP 响应报文的第一行是状态行,由版本字段开始,其后跟一个空格,后跟状态码字段旗号跟一个空格,后跟短语字段,最后是回车换行。除状态行外, HTTP 响应报文的其他部分与 HTTP 请求报文格式的对应部分是相似的,我们就不再赘述了。
状态行中的状态码共分为 5 大类,共 33 种。我们举例说明响应报文中常见的状态行,该状态行表示服务器接受了请求。 HTTP 1. 1 表示版本 202 是状态码, accepted 的是短语,也就是对状态码的简单描述。该状态行表示请求错误,而该状态行表示找不到所请求的页面。一般来说,浏览器并不会直接显示出服务器发来的这些状态行信息,而是以更友好的形式向用户告知服务器所返回的状态信息。例如,当我们访问某些网站时,浏览器可能会显示类似该图所示的提示信息,其背后的本质是浏览器收到了包含这条状态行的响应报文。在我们访问网站时,浏览器通常会使用 cookie 在服务器上记录用户信息。早期的万维网应用非常简单,仅仅是用户查看存放在不同服务器上的各种静态的文档。因此, HTTP 被设计成为一种无状态的协议,这样可以简化服务器的设计。现在,用户可以通过万维网进行各种复杂的应用,如网上购物、电子商务等,这些应用往往需要万维网服务器能够识别用户。例如,我们使用浏览器在某个网站上已经注册了自己的账号,当在该网站上登录自己的账号时,除了输入用户名和密码外,我们还可以选择记住我选项。这样,当我们下一次使用该浏览器再次访问该网站时,网站可以自动识别出我们,而不用我们再次输入账号信息。
cookie 提供了一种机制,使得万维网服务器能够记住用户,而无需用户主动提供用户标识信息。也就是说, cookie 是一种对无状态的 HTTP 进行状态化的技术。我们来举例说明 cookie 的工作原理。用户主机中的浏览器进程首先与万维网服务器中的服务器进程建立 TCP 连接。当用户的浏览器进程初次向服务器进程发送 HTTP 请求报文时,服务器进程就会为其产生一个唯一的 cookie 识别码,并以此为索引。
在服务器的后端数据库中创建一个项目,用来记录该用户访问该网站的各种信息,接着就会给浏览器进程发回 HTTP 响应报文。在响应报文中包含有一个首部字段为 set cookie 的首部行,该字段的取值就是 cookie 识别吗?当浏览器进程收到该响应报文之后,就在一个特定的 cookie 文件中添加一行记录该服务器的域名和 cookie 的识别码。当用户再次使用浏览器访问这个网站时,每发送一个 HTTP 请求报文,浏览器都会从 cookie 文件中取出该网站的 cookie 识别码,并放到 HTTP 请求报文的cookie。首部杭州服务器根据 cookie 识别码就可以识别出该用户,并返回该用户的个性化网页。
接下来我们介绍万维网缓存与代理服务器。在万维网中还可以使用缓存机制,以提高万维网的效率。万维网缓存又称为 web 缓存,可位于客户机,也可位于中间系统上的外部缓存,又称为代理服气外部缓存。把最近的一些请求和响应暂存在本地磁盘中,当新请求到达时,若发现这个请求与栈池存放的请求相同,就返回栈存的响应,而不需要按统一资源定位符的地址再次去因特网访问该资源,我们来举例说明。
假设这是因特网上的某台万维网服器,为了与万维网代理服器的名称区分,我们简称该服务器为原始服务器。这是校园网中的某台万维网代理服务器,我们简称其为代理服务器。当校园网中的某台主机要访问因特网上的原始服务器时,他首先会向校园网中的代理服务器发送请求。若代理服务器中存放有所请求的对象,则代理服务器会向该主机发回包含所请求对象响应。若代理服务器中没有所请求的对象,则代理服务器会向因特网上的原始服务器发送请求。原始服务器将包含有所请求对象的响应发回给代理服器,代理服务器将该响应存弱外部缓存,然后给主机发回该响应。可以想象,如果外部缓存的命中率比较高,则路由器 R1 和 R2 之间的链路上的通信量将大大减少,因而可以减少校园网各主机访问因特网的时延。
有的同学可能会有这样的疑问,这是原始服务器中的某个文档,这是该文档在代理服务器中的副本。假设原始服务器中的该文档已被更改,之后校园网中的某台主机要请求该文档,他首先向校园网中的代理服务器发送请求,代理服务器找到该文档后,将其封装在响应报文中发回给主机。这样,主机所请求到的文档与原始服务器中的文档就不一致了。
实际上,原始服务器通常会为每个响应的对象设定一个修改时间字段和一个有效日期字段。当校园网中的某台主机要请求原始服务器中的该文档时,他首先向校园网中的代理服务器发送请求。若代理服务器中的该文档未过期,则代理服务器将其封装在响应报文中发回给主机。若代理服务器中的该文档已过期,则代理服务器会向因特网上的原始服务器发送请求。在请求报文中包含有一个首部字段为 if modified since 的首部行,该字段的取值就是该文档的修改日期。原始服务器根据该文档的修改日期就可判断出代理服务器中存储的该文档是否与自己存储的该文档一致,如果一致,则给代理服务器发送不包含实体主体的响应状态码为304,短语为 not modified。
代理服务器重新更新该文档的有效日期,然后将该文档封装在响应报文中发回给主机。如果不一致,则给代理服务器发送封装有该文档的响应报文,如图所示,这样代理服务器就更新了该文档,然后将更新后的该文档封装在响应报文中发回给主机。最后,我们来做两个相关的练习题,这是计算机专业考研全国统考计算机网络部分 2015 年的题40。请同学们暂停播放视频思考一下,给出你的答案。答案是选项c,大家都选对了吗?我们来一起分析一下请求报文的第一行为。请求行指明了方法, get 所请求对象的统一资源定位符以及 HTTP 的版本,因此选项 a 的描述正确。这是请求行下面的第一个首部行,首部字段名为host,其职为网站的域名,因此选项 b 的描述正确。这是第二个首部行,首部字段名为connection,其值为close。这是告诉服务器发送完请求的文档后就可以释放连接。借,非持续连接,若是持续连接方式取值因为 keep alive 而不是close,因此选项 c 的描述错误。
这是第三个首部行,首部字段名为cookie,其值是服务器给浏览器生成的 cookie 识别码,表明该浏览器曾经访问过该网站,因此选项 d 的描述正确。再来做这道练习题,请同学们暂停播放视频,思考一下,给出你的答案。本题稍有难度,我们来一起分析一下。
这是浏览器与服务器之间通过三报文握手进行 TCP 连接。在这 3 个报文中的最后一个报文的数据载荷部分携带有 HTTP 请求。报文请求的对象是 RFC 点 HTML 页面,服务器收到后给客户发回包含有该对象的 HTTP 响应报文。由于 RFC 点 HTML 页面中引用了另外两个 JPACK 小图像,则浏览器也会继续依次分别请求这两个对象。
很显然,浏览器从开始建立 TCP 连接到收到全部内容为止,需要 4 个RTT。本题的解题关键在于对 HTTP 中持续连接方式的理解以及非流水线方式的理解。由于这些概念刚刚在本节课中介绍过,因此就不再赘述了。本节课到这里就结束了,我们将本节课的内容小结如下,同学们,我们下节课再见。