[toc]

涉及知识
Github 监控收集信息
意义
- 便于收集整理最新exp或poc
- 便于发现相关测试目标的资产
监控Github最新的EXP发布及其他
利用微信推送CVE-2020-项目地址
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
|
import requests
import json
import time
import os
import pandas as pd
time_sleep = 20
while(True):
headers = {
"User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.25 Safari/537.36 Core/1.70.3741.400 QQBrowser/10.5.3863.400"}
datas = []
response1=None
response2=None
if os.path.exists("olddata.csv"):
df = pd.read_csv("olddata.csv", header=None)
datas = df.where(df.notnull(),None).values.tolist()
response1 = requests.get(url="https://api.github.com/search/repositories?q=CVE-2020&sort=updated&per_page=10",
headers=headers)
response2 = requests.get(url="https://api.github.com/search/repositories?q=RCE&ssort=updated&per_page=10",
headers=headers)
else:
datas = []
response1 = requests.get(url="https://api.github.com/search/repositories?q=CVE-2020&sort=updated&order=desc",headers=headers)
response2 = requests.get(url="https://api.github.com/search/repositories?q=RCE&ssort=updated&order=desc",headers=headers)
data1 = json.loads(response1.text)
data2 = json.loads(response2.text)
for j in [data1["items"],data2["items"]]:
for i in j:
s = {"name":i['name'],"html":i['html_url'],"description":i['description']}
s1 =[i['name'],i['html_url'],i['description']]
if s1 not in datas:
params = {
"text":s["name"],
"desp":" 链接:"+str(s["html"])+"\n简介"+str(s["description"])
}
print("当前推送为"+str(s)+"\n")
print(params)
requests.get("https://sc.ftqq.com/XXXX.send",params=params,timeout=10)
print("推送完成!")
datas.append(s1)
else:
pass
pd.DataFrame(datas).to_csv("olddata.csv",header=None,index=None)
time.sleep(time_sleep)
|
监控工具使用方法
安装程序必要的Python包
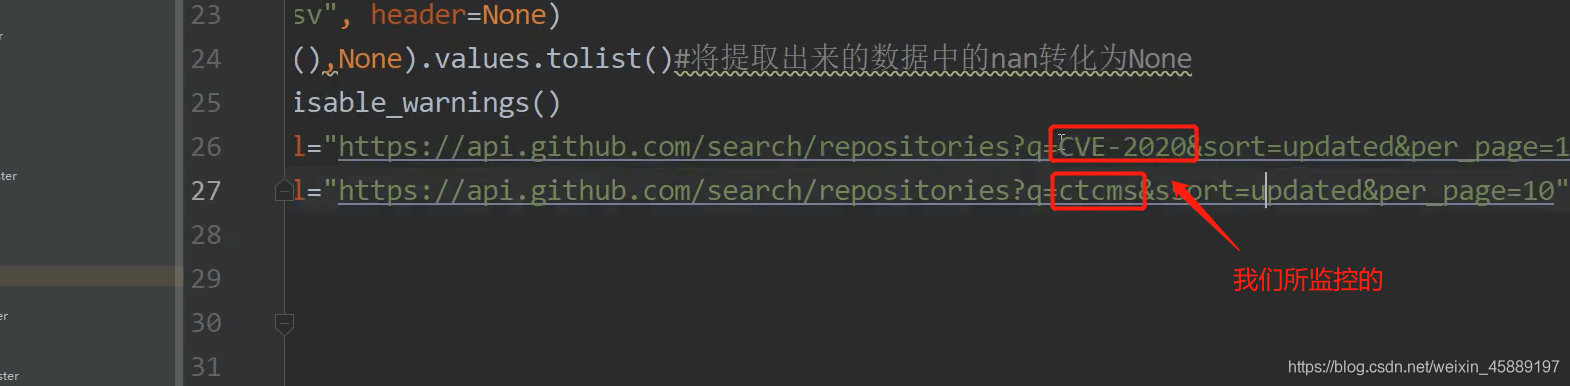
此程序默认监控以下2个内容
根据需求自行修改需要监控的资产关键字
- CVE-2020 监控今年出现的漏洞编号
- ctcms 监控ctcms资产信息
Server酱配置微信推送
微信登录后生成Sendkey——复制到上述代码低50行处填写
requests.get("https://sc.ftqq.com/XXXX.send",params=params,timeout=10)
绑定微信,运行脚本,就可以获取到监控的内容
各种子域名查询
1. 全自动域名收集枚举优秀脚本使用(teemo)
项目地址
https://github.com/bit4woo/teemo Python2.7环境
使用配置
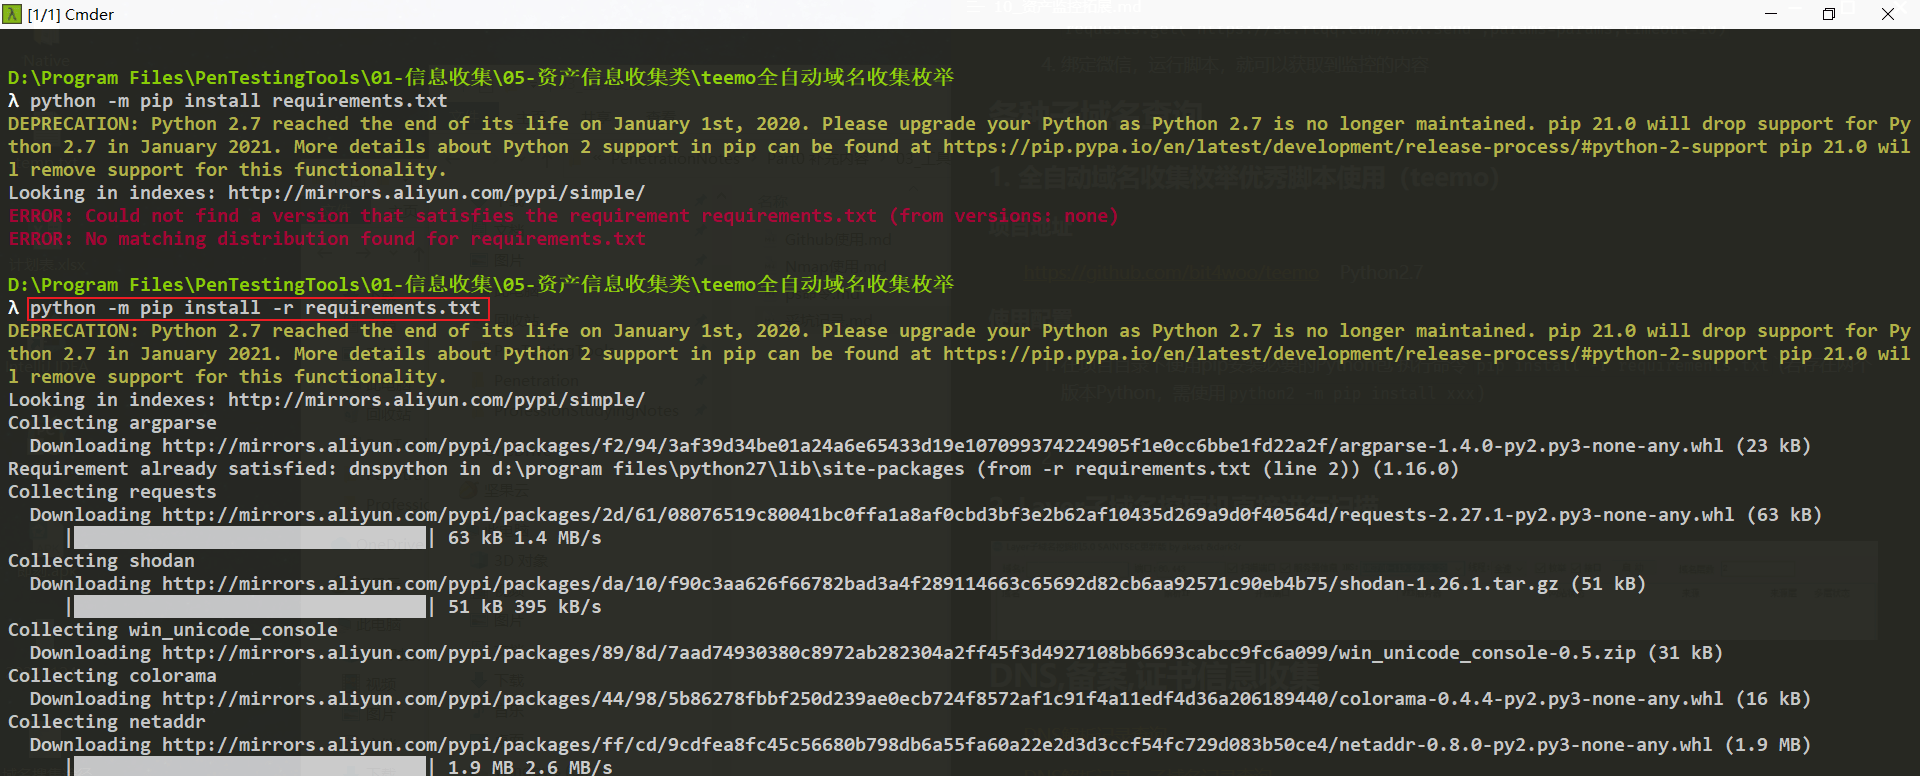
在项目目录下使用pip安装必要的Python包(所需扩展包在requirements.txt文件中)执行命令pip install -r requirements.txt(若存在两个版本Python,需使用python2 -m pip install xxx,即python -m pip install -r requirements.txt)
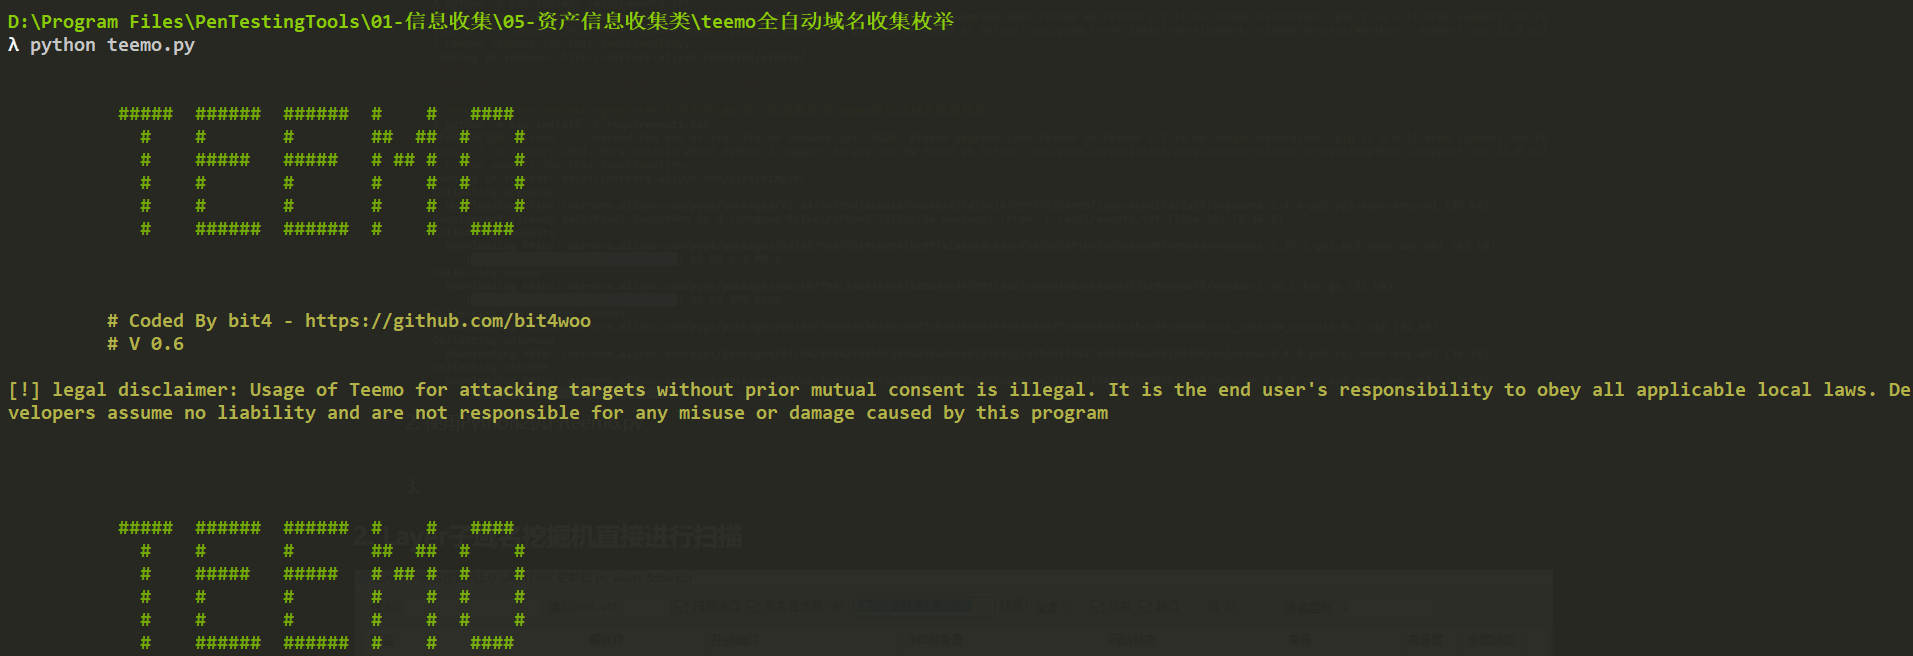
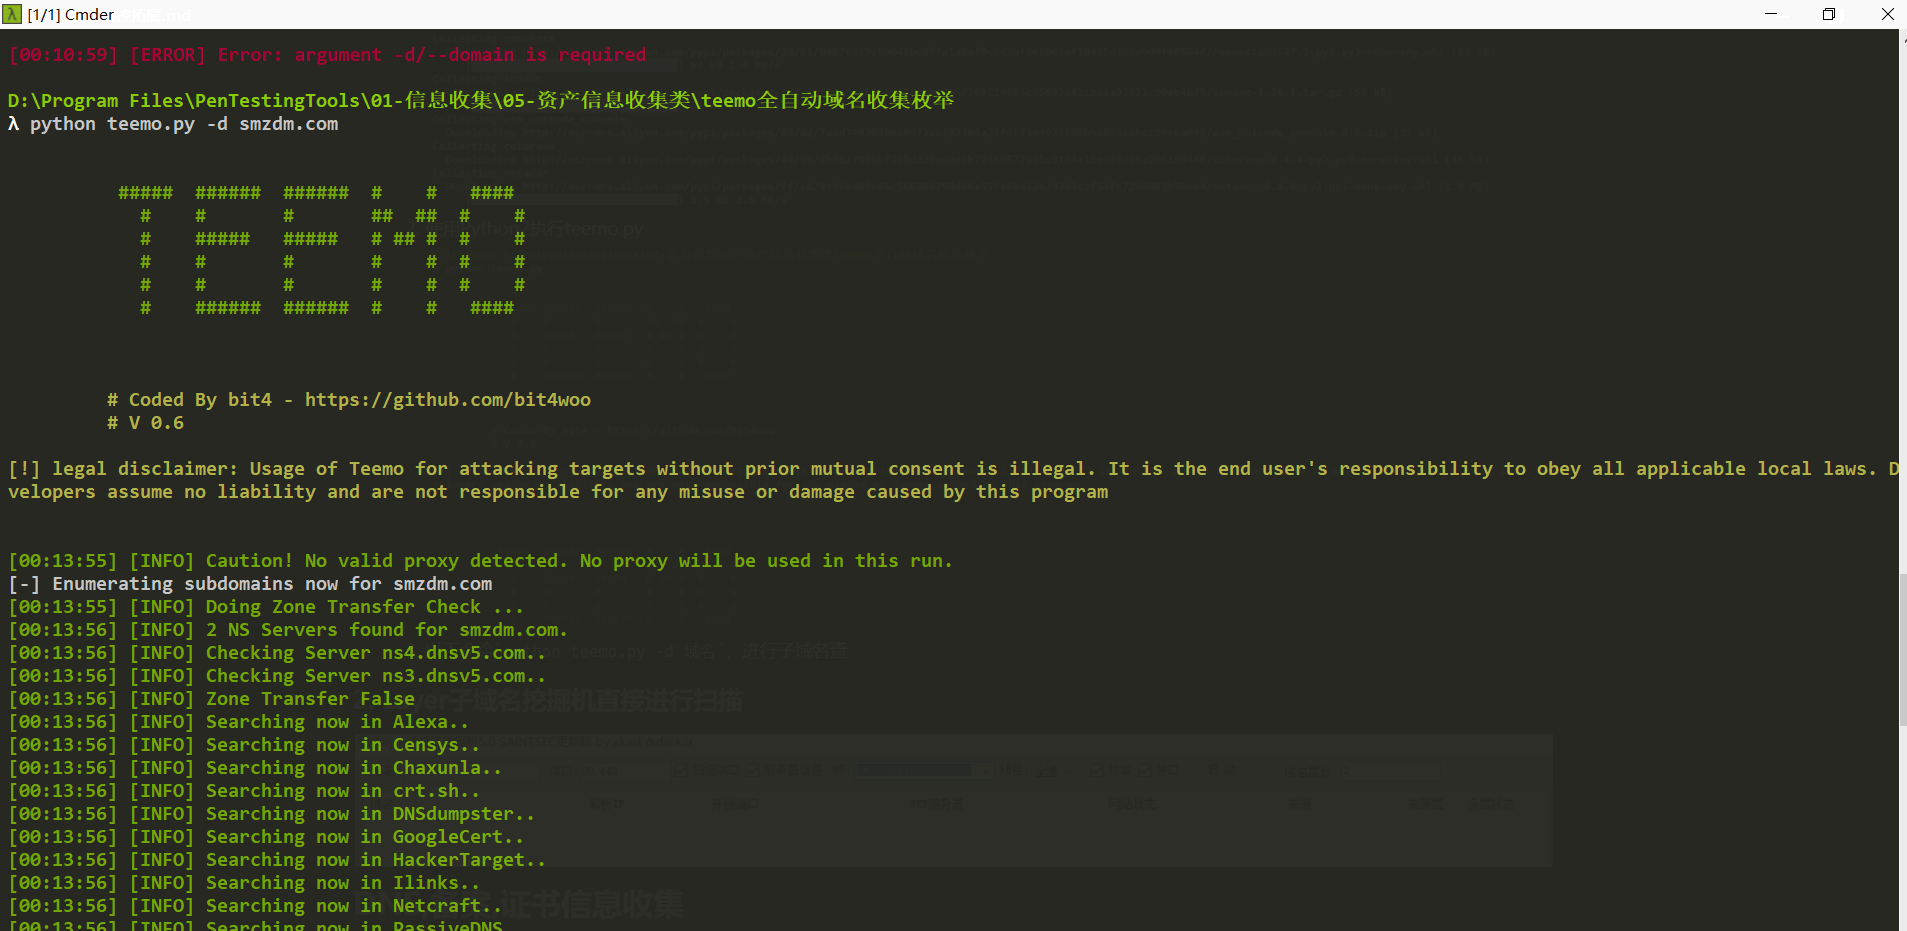
使用Python2执行teemo.py如下所示说明运行成功
以下命令python teemo.py -d 域名,进行子域名查询
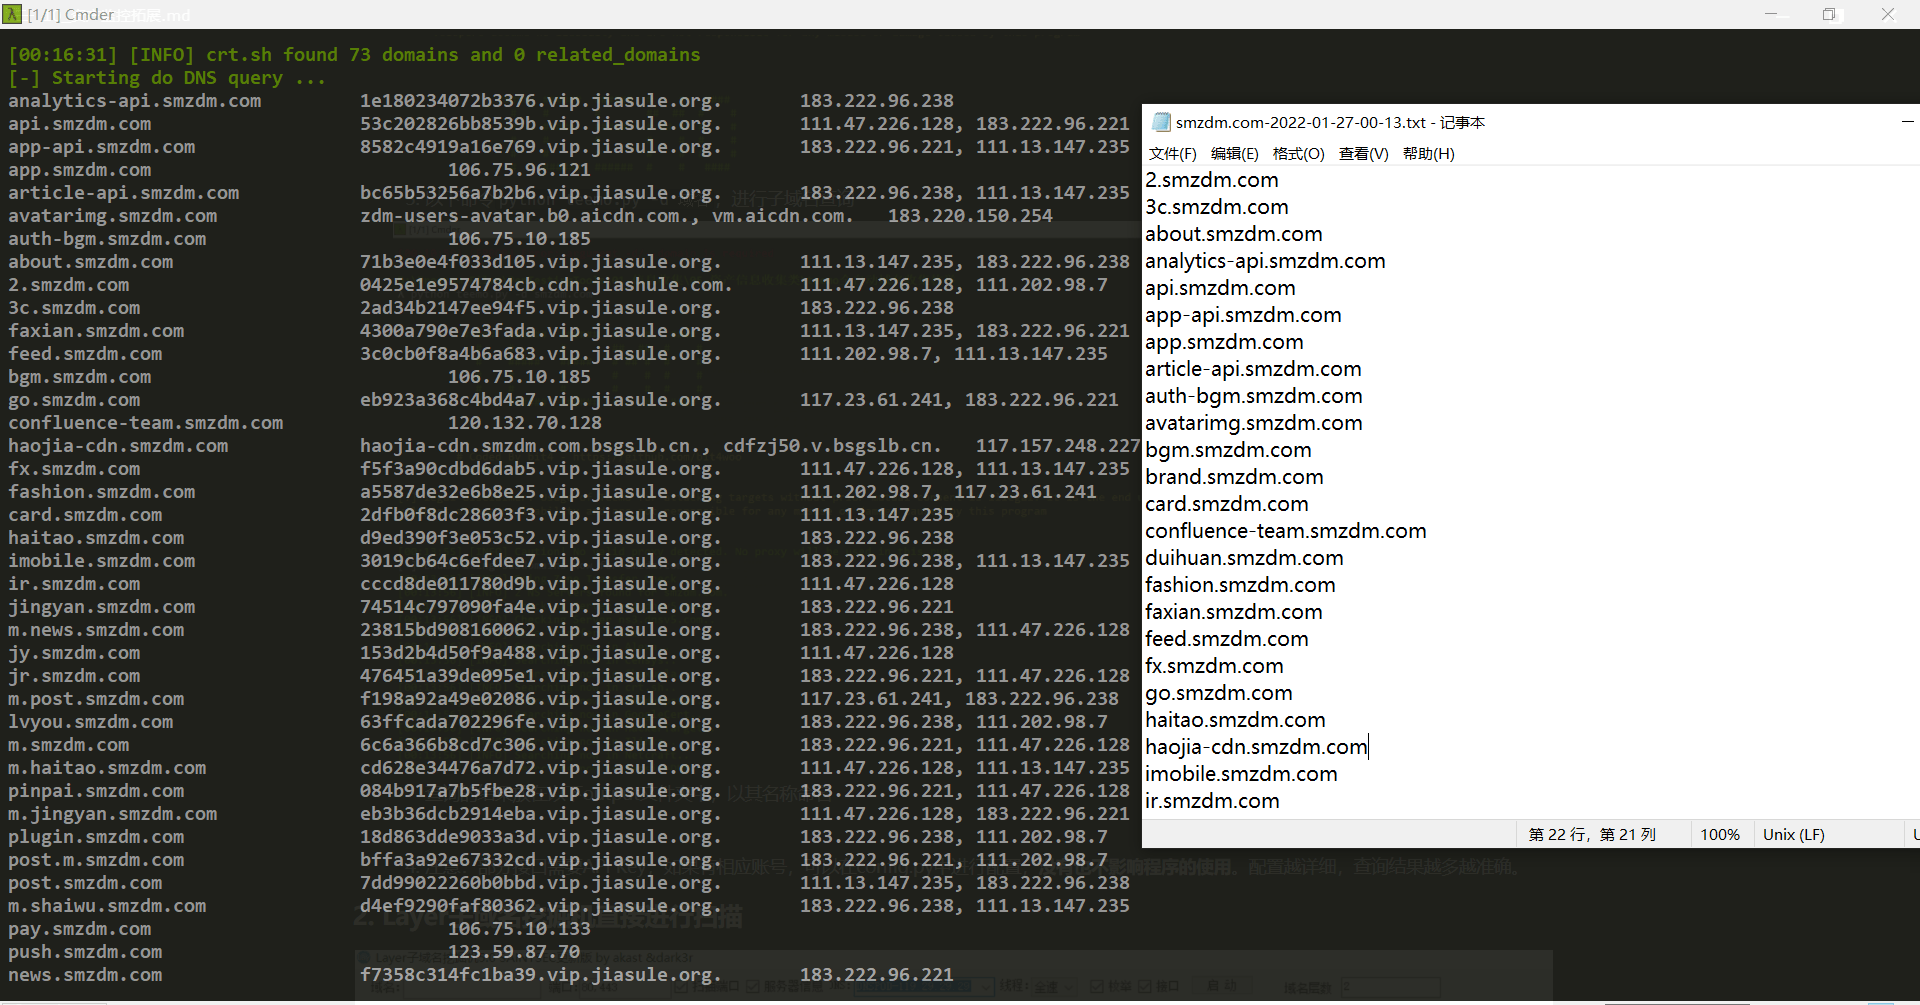
查询的结果放在以下output文件夹中,以其名称命名
注意:部分接口需要API Key,如果有相应账号,可以在config.py中进行配置,没有也不影响程序的使用。配置越详细,查询结果越多越准确。
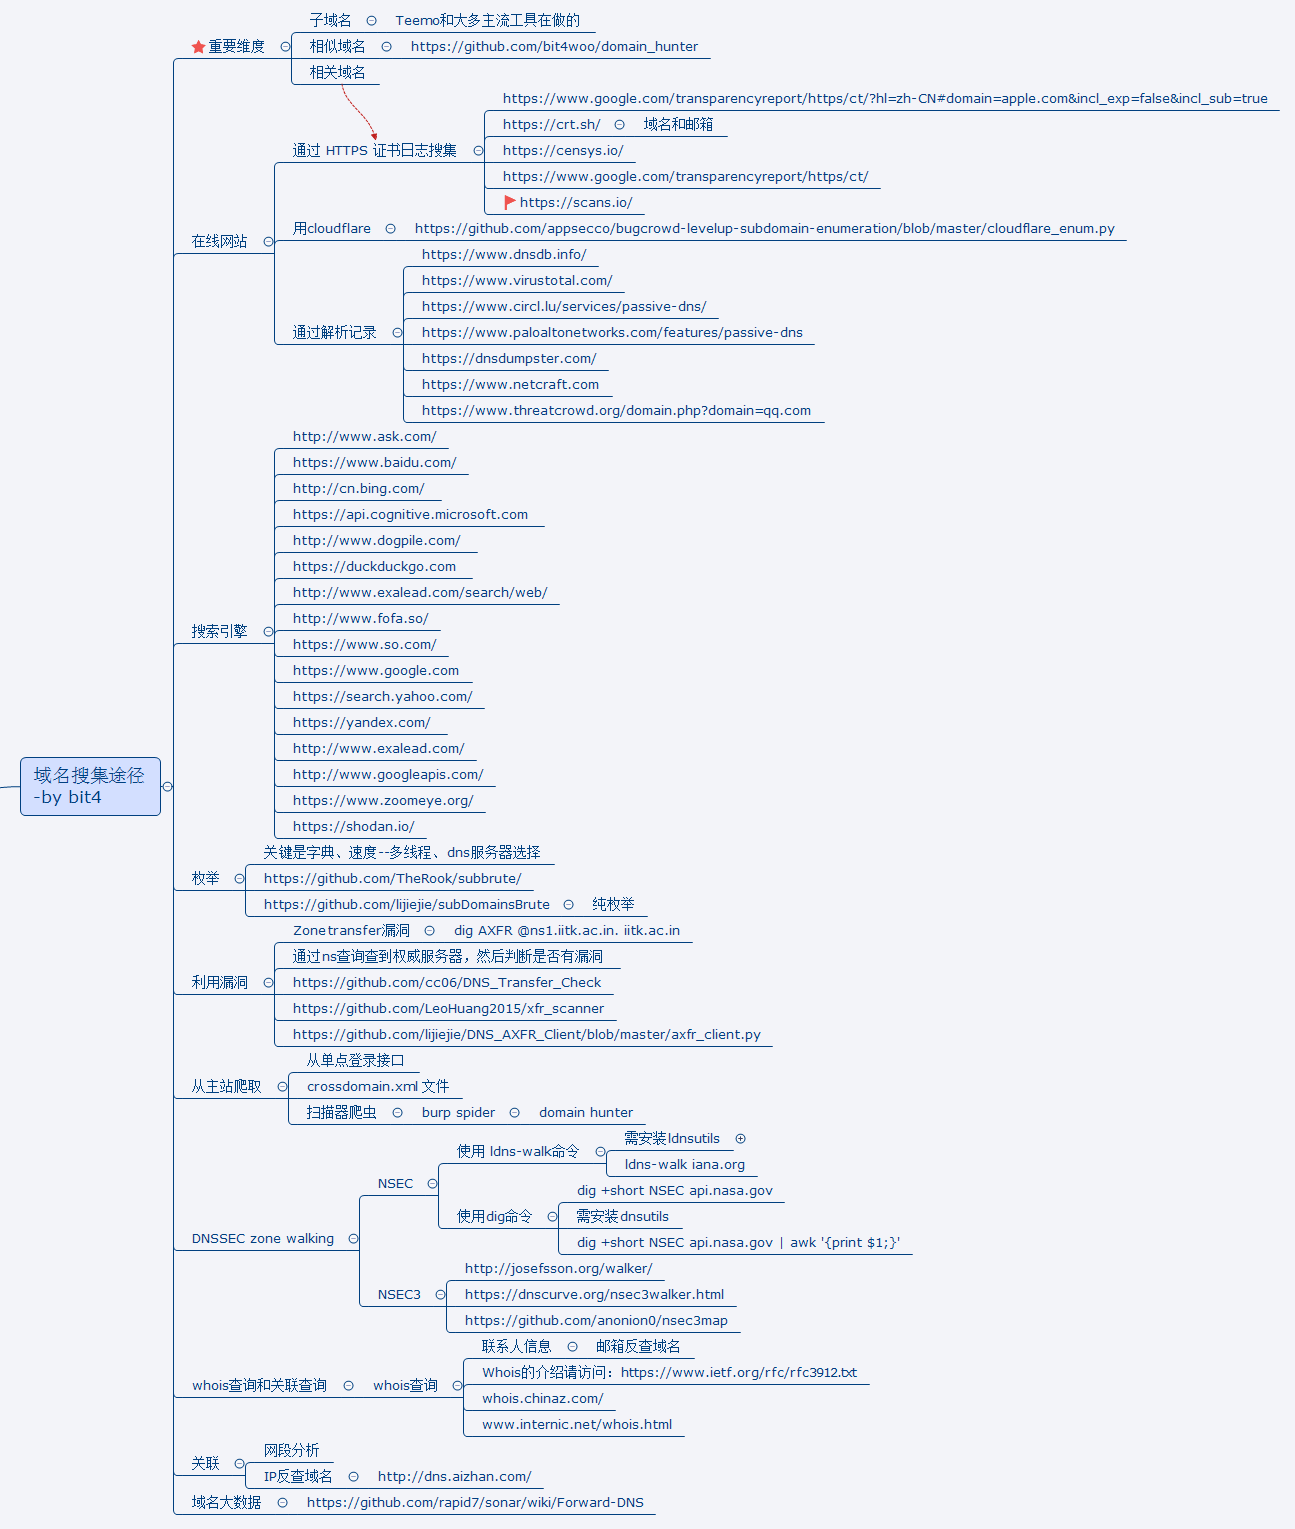
域名搜集路线图by bit4
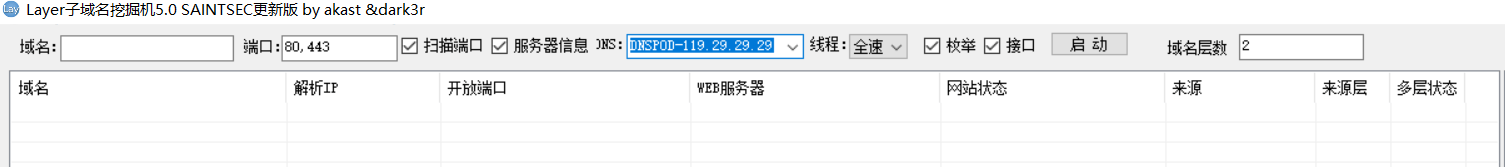
2. Layer子域名挖掘机直接进行扫描
DNS,备案,证书信息收集
DNS解析记录查询
DNS解析记录、子域名记录查询
站长之家备案信息查询
网站证书查询
全球节点请求cdn
免费全球节点请求绕过CDN
枚举爆破或解析子域名对应
便于发现管理员相关的注册信息
黑暗引擎相关搜索
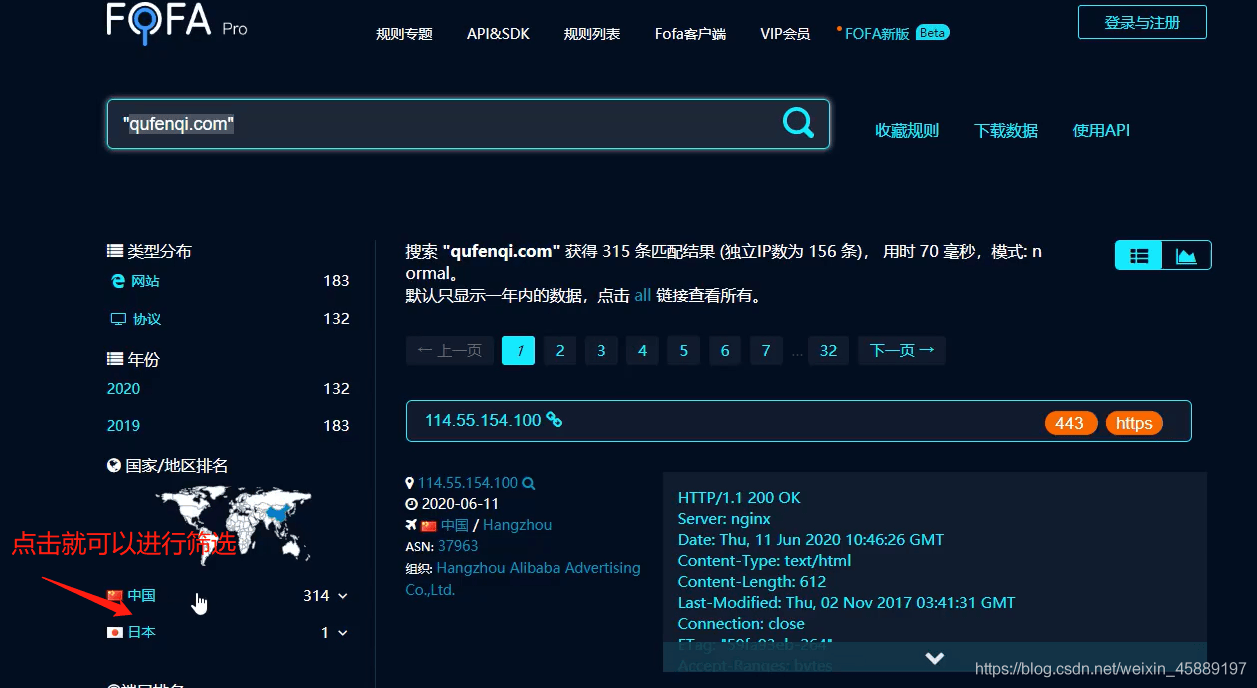
黑暗引擎
以FOFA为例使用黑暗引擎实现域名端口等收集
微信公众号接口获取
一般的网站都会使用有自己的微信公众号,可通过公众号内容获得一些可用的信息
内部群内部应用内部接口
涉及案例
监控Github最新的EXP发布及其他
(见上)
黑暗引擎实现域名端口等收集
(见上)
全自动域名收集枚举优秀脚本使用(teemo)
(见上)
SRC目标中的信息收集全覆盖——补天上专属SRC简易测试
==//==
涉及资源